錄音停了兩秒,字幕還有下一句
逐字稿不是聲音的複印件。當音訊線索變弱,模型仍可能給出流暢文字;流暢只能說明它像一句話,不能證明有人說過。
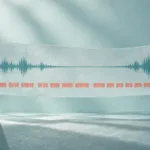
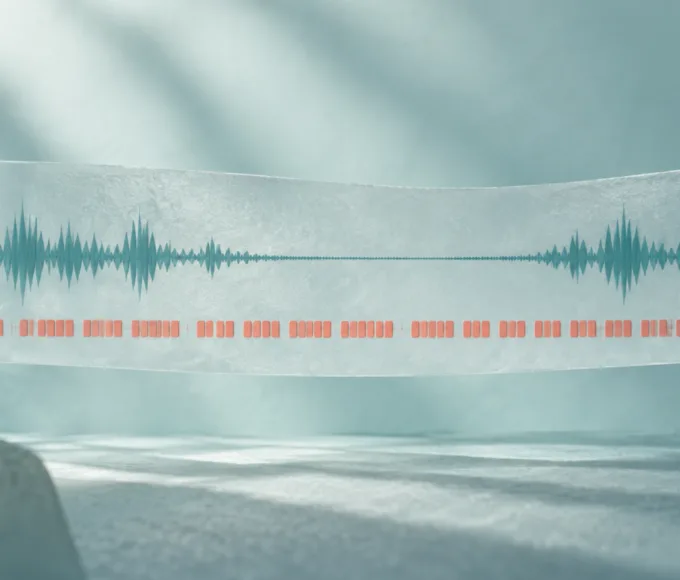
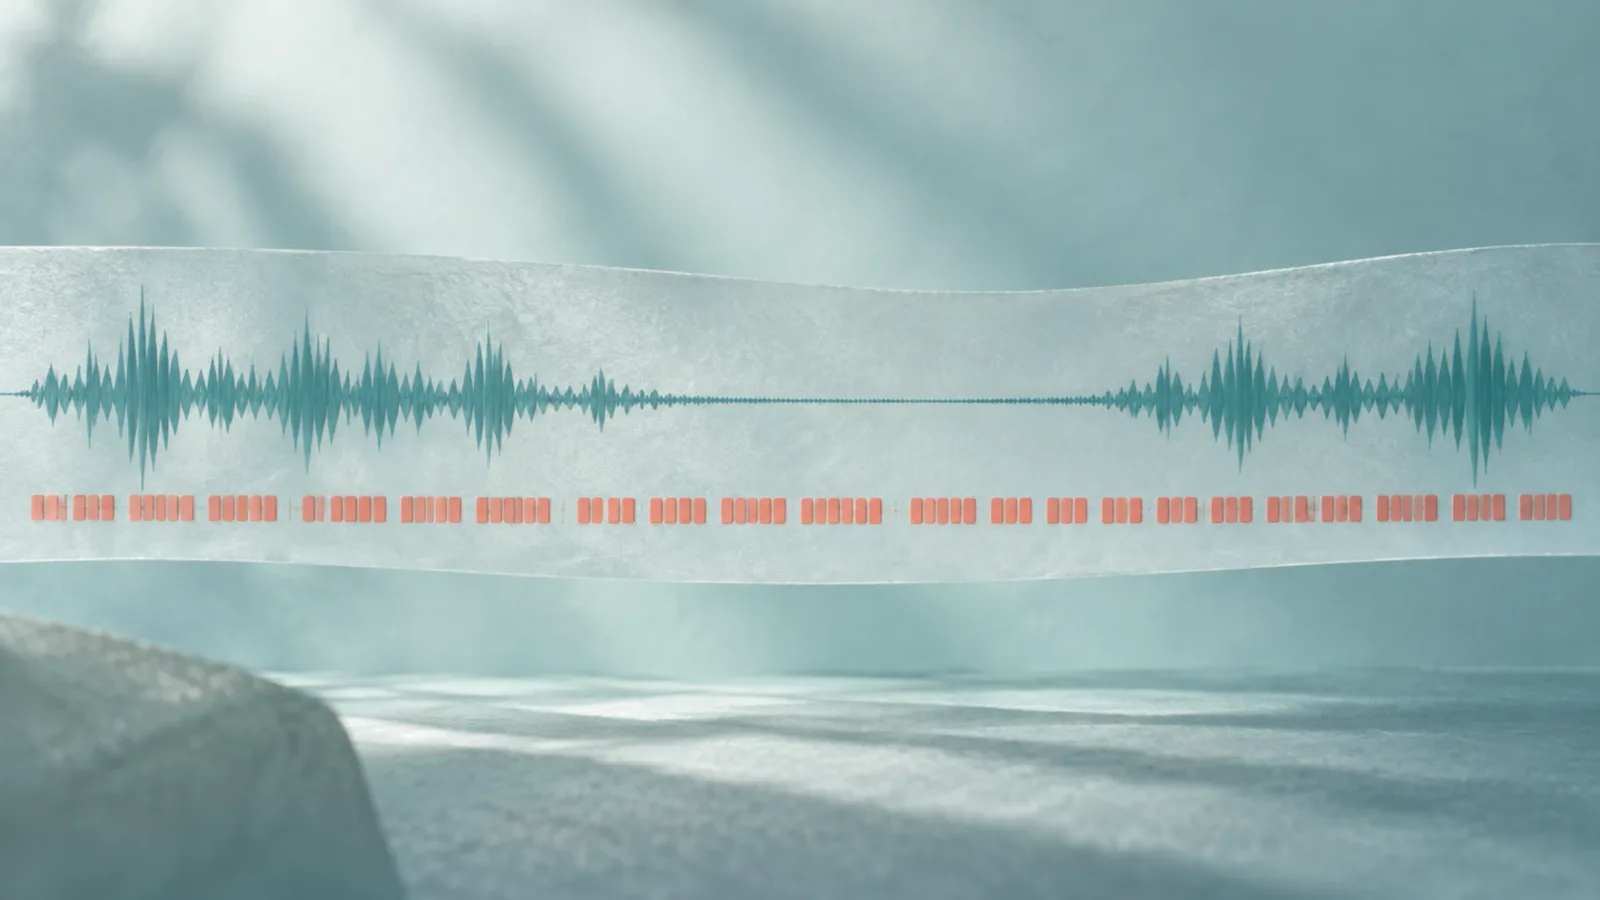
聲音視角:上方在停頓處變平;下方的字幕示意仍連續。
先想像一段會議錄音:一位同事說完半句,接著兩秒只有風扇聲。自動逐字稿卻在那裡接上一句完整的答覆。這是用來討論的假設情境,不指向任何真實會議。若有人拿這份紀錄追問「你剛才是不是答應了」,哪一層才算證據?
先把答案放在桌上:逐字稿是模型依聲音產生的估計,不是錄音的複印件。它可以幫忙整理內容,不能獨自證明某句話真的被說出口。
兩秒鐘沒有消失
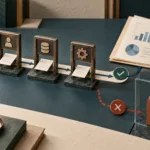
Whisper 是 OpenAI 推出的一種語音辨識模型。它不是拿著一卷錄音帶,把有聲的地方剪成字。OpenAI 說明,Whisper 會把音訊切成片段、轉成一種表示聲音頻率與時間的圖,再由編碼器處理;接著,解碼器預測對應的文字和任務標記。
音訊片段
聲音波形與停頓
頻率與時間表示
把聲音轉成可運算的特徵
文字預測
解碼器預測文字與任務標記
這裡的「預測」很重要。模型接收到的是聲音資料,不是人類耳朵已經確認的逐字稿。兩秒停頓仍可能帶著房間底噪、風扇聲、呼吸或很弱的發音;模型必須把這些線索映成一串文字,或判斷它們不足以形成文字。語音辨識不是把聲音原封不動搬到紙上。
OpenAI 的 Whisper 模型卡承認,輸出可能包含錄音裡沒有說過的文字。模型卡把一種可能成因寫成假設:模型一面辨認聲音,一面也運用對語言接續方式的預測。這是廠商提出的解釋,不是已證實的唯一機制。重要的是結果:一句話即使文法完整,也可能沒有足夠的聲音證據。
所以,這不是模型「故意說謊」。比較準確的說法是:模型交出一個看似合理的估計,而估計越過了錄音能支持的範圍。字幕流暢,不能替聲音補出不存在的證明。
兩扇研究窗,兩種分母
含英語說話與停頓的句段
1.4%2024 FAccT 研究平均含幻覺的轉錄
13,140 段 AphasiaBank 英語音訊;2023 年 Whisper API 測試
刻意送入的不含語音聲音
40.3%2025 預印本壓力測試中的幻覺推論
301,317 筆非語音輸入;Whisper large-v3 英文設定
2024 年 ACM FAccT 會議的一項研究,把 Whisper API 用在 13,140 段英語短句音訊上。素材來自 TalkBank 的 AphasiaBank,包含失語症者與對照組的說話片段。研究團隊在 2023 年春季進行轉錄;他們回報平均約 1.4% 的轉錄含有幻覺文字。按樣本分組,失語症者的片段約有 1.7% 出現幻覺,對照組約為 1.2%。研究者也把 38% 的幻覺文字歸入暴力內容、不實的人事或健康關聯,以及假冒權威等三類。
這些數字描述的是特定英語資料、特定 API 測試時段與研究定義,不是每一種逐字稿工具的通用錯誤率。它們提醒的是另一件事:即使多數句子大致正確,少數被添上的字仍可能改變一份紀錄的意思。
另一扇研究窗刻意把條件換掉。2025 年一份 arXiv 預印本讓 Whisper large-v3 處理 301,317 筆不含語音的音訊輸入,包含靜音、噪音、音樂與環境聲;測試使用英文設定與固定解碼溫度。在這種刻意製造的壓力測試中,研究把 40.3% 的推論結果判定為幻覺文字。這不是日常錄音的發生率:資料本來就不含語音,問題正是看模型會不會仍然寫出句子。
1.4% 和 40.3% 不能放在一起平均。前者看的是含有自然說話與停頓的句段;後者把沒有語音的聲音直接送進模型。換了房間,也換了分母。研究數字要連同資料、語言、模型版本與測試方式一起讀,才知道它回答的是哪個問題。
停頓不是說話者的缺陷
FAccT 研究還發現,失語症組在該資料中的幻覺比例高於對照組,較長的非語音時段也和較高的幻覺機率相關。這不能解讀成「停頓會造成幻覺」或「某種說話方式一定會被寫錯」;研究指出的是特定樣本中的關聯。它讓人看見:當說話有較長停頓、弱音或不流暢時,模型更可能缺少能穩穩支撐字幕的線索。
這個差別不只關乎一個字有沒有辨認正確。研究列出的風險包括替說話者添上不實的人事或健康資訊、暴力內容,或把一句話錯接成某種權威來源。這些是論文歸納的可能傷害類型,不代表每次轉錄都會出現。論文的樣本是美國英語語料,不能直接推算台灣華語或今日每一套服務的比例。
把字幕當成一份「已確認的逐字記錄」,會讓那個補上的句子離開原本的聲音,進入會議紀錄、病歷或決策材料。到那一步,標點和語氣看起來再自然,也不會讓它變成錄音裡真的存在過的話。
把字幕放回聲音旁邊
回到開頭那段假設錄音:播放到同事停下來的地方,只剩兩秒風扇聲。字幕可以替人快速定位、搜尋與整理;但要判斷那句答覆是否真的說過,仍得回到錄音。聽不清楚時,標記「不確定」比替空白補上一句更誠實。
因此,重要紀錄應保留可核對的原音與時間點,並由人檢查涉及承諾、姓名、藥物或責任歸屬的字句。若原音本身也無法分辨,就把不確定留在紀錄裡。這是根據上述研究與證據邊界提出的編輯做法,不是某一篇研究已驗證的軟體功能。
字幕是一張返回聲音的索引,不是聲音的替身。那兩秒不必由模型替任何人填滿。
資料來源與研究範圍
- OpenAI,Introducing Whisper(2022):Whisper 的音訊表示、編碼器/解碼器流程與模型定位。
– OpenAI,Whisper large model card:模型限制、可能輸出未說過的文字,以及廠商對語言預測影響的假設。
– Koenecke 等人,Careless Whisper: Speech-to-Text Hallucination Harms(ACM FAccT 2024):AphasiaBank 英語樣本、2023 API 測試與幻覺文字分析。
– Barański 等人,Investigation of Whisper ASR Hallucinations Induced by Non-Speech Audio(2025,arXiv 預印本):Whisper large-v3 對非語音輸入的控制實驗;其比率不代表一般錄音發生率。